Wer ein Angebot für ein KI-Projekt liest, stößt auf dreißig Begriffe, von denen fünfzehn nicht erklärt werden. Ein Teil davon bedeutet im Marketing etwas anderes als in der Technik. Das ist ein Problem, denn du sollst Angebote vergleichen und Risiken einschätzen, ohne die Sprache zu beherrschen, in der sie geschrieben sind.
Hier stehen die Begriffe, die uns in Kundenprojekten tatsächlich begegnen. Jeder bekommt eine Definition und einen Satz dazu, was er für dich praktisch heißt. Wo Marketingsprache und Technik auseinandergehen, schreiben wir es hin. Du musst das nicht am Stück lesen, spring zu dem Abschnitt, der dich betrifft.
Was sind die Grundbegriffe der Künstlichen Intelligenz?
Künstliche Intelligenz (KI) ist ein Sammelbegriff für Software, die Aufgaben löst, für die früher ein Mensch nötig war. Der Begriff allein sagt nichts über das Verfahren. Frag bei jedem Angebot nach, welche Technik konkret dahintersteckt.
Maschinelles Lernen ist das Verfahren, bei dem ein Programm Muster aus Daten ableitet, statt dass jemand Regeln von Hand schreibt. Fast alles, was heute KI genannt wird, ist maschinelles Lernen.
Ein Large Language Model (LLM), auf Deutsch Sprachmodell, ist ein Modell, das Text fortsetzt. Es berechnet das wahrscheinlichste nächste Textstück, wieder und wieder. ChatGPT, Claude und Gemini sind Oberflächen für solche Modelle.
Ein Sprachmodell weiß nichts. Es erzeugt Text, der zu dem passt, was es gelesen hat.
Dieser Unterschied erklärt die meisten Enttäuschungen in KI-Projekten.
Ein Token ist die Abrechnungs- und Recheneinheit eines Sprachmodells. Im Deutschen entspricht ein Token grob einem halben bis dreiviertel Wort, weil Komposita wie "Auftragsverarbeitung" in mehrere Teile zerlegt werden. Abgerechnet wird getrennt nach Eingabe und Ausgabe, und die Eingabe ist fast immer der größere Posten. Ein Beispiel aus unserem eigenen Betrieb: Ein Lauf, in dem vier Agenten sieben geprüfte Befunde beurteilen, hat am 4. Oktober 2026 rund 69.900 Token gelesen und 9.800 geschrieben. Das Verhältnis von sieben zu eins ist typisch. Wenn dir jemand Kosten nennt, lass dir die Zahl pro Vorgang in Token geben, nicht pro Anfrage.
Ein Prompt ist die Anweisung an das Modell. Ein brauchbarer Prompt legt vier Dinge fest: die Rolle, die Aufgabe, die Grenzen und das Format der Antwort. So sieht das aus:
Rolle: Du bist Sachbearbeiter in der Buchhaltung.Aufgabe: Lies die Rechnung und gib Rechnungsnummer, Datum und Bruttobetrag zurück.Grenze: Wenn ein Wert fehlt, schreib „fehlt". Rate nicht.Format: Antworte als JSON mit genau diesen drei Feldern.
Die dritte Zeile ist die wichtigste. Ohne sie füllt das Modell Lücken mit Plausiblem.
Das Kontextfenster ist die Textmenge, die ein Modell gleichzeitig berücksichtigen kann, gemessen in Token. Was darüber hinausgeht, fällt weg. Deshalb vergessen lange Gespräche irgendwann ihren Anfang.
Eine Halluzination ist eine erfundene Information, die das Modell mit derselben Sicherheit ausgibt wie eine richtige. Das ist kein Programmfehler, sondern eine Eigenschaft des Verfahrens: Ein Modell, das das wahrscheinlichste nächste Wort wählt, hat keinen Begriff von wahr und falsch. Wer dir verspricht, seine KI halluziniere nicht, verkauft dir etwas. Was es gibt, sind Aufbauten, in denen das Modell wenig zu erfinden hat, weil gemessen und gerechnet wird und nur die Beurteilung beim Modell liegt.
Die Temperatur ist ein Regler für Zufall in der Antwort. Niedrig heißt vorhersagbar und wiederholbar, hoch heißt abwechslungsreich. Für Rechnungen und Einsortieren niedrig, für Textideen höher.
Inferenz ist der Lauf des Modells, also die Beantwortung einer Anfrage. Daran hängen Kosten und Wartezeit.
Multimodal heißt, dass ein Modell nicht nur Text versteht, sondern auch Bild, Audio oder Video. Praktisch wird das, wenn ein Beleg fotografiert statt abgetippt wird.
Open Weights bedeutet, dass die Gewichte eines Modells frei verfügbar sind und du es auf eigener Hardware betreiben kannst. Das ist nicht dasselbe wie Open Source, denn die Trainingsdaten bleiben meist geheim. Relevant wird es, wenn Daten dein Haus nicht verlassen dürfen.
Wie bekommt eine KI Zugriff auf meine Firmendaten?
Für diese Frage gibt es zwei Wege, und die Verwechslung ist teuer. Beim einen liest das Modell deine Daten bei jeder Anfrage neu, beim anderen wird es damit verändert.
|
|
RAG |
Feintuning |
|---|---|---|
|
Was passiert |
Passende Stellen kommen vor der Antwort in den Prompt |
Das Modell wird mit deinen Daten nachtrainiert |
|
Aufwand |
Tage bis Wochen |
Wochen, plus Datenaufbereitung |
|
Wissen ändern |
Dokument tauschen, wirkt sofort |
Erneutes Training |
|
Daten entziehbar |
Ja |
Praktisch nein |
|
Wofür |
Fachwissen, Dokumente, Preise |
Tonfall, Format, Spezialsprache |
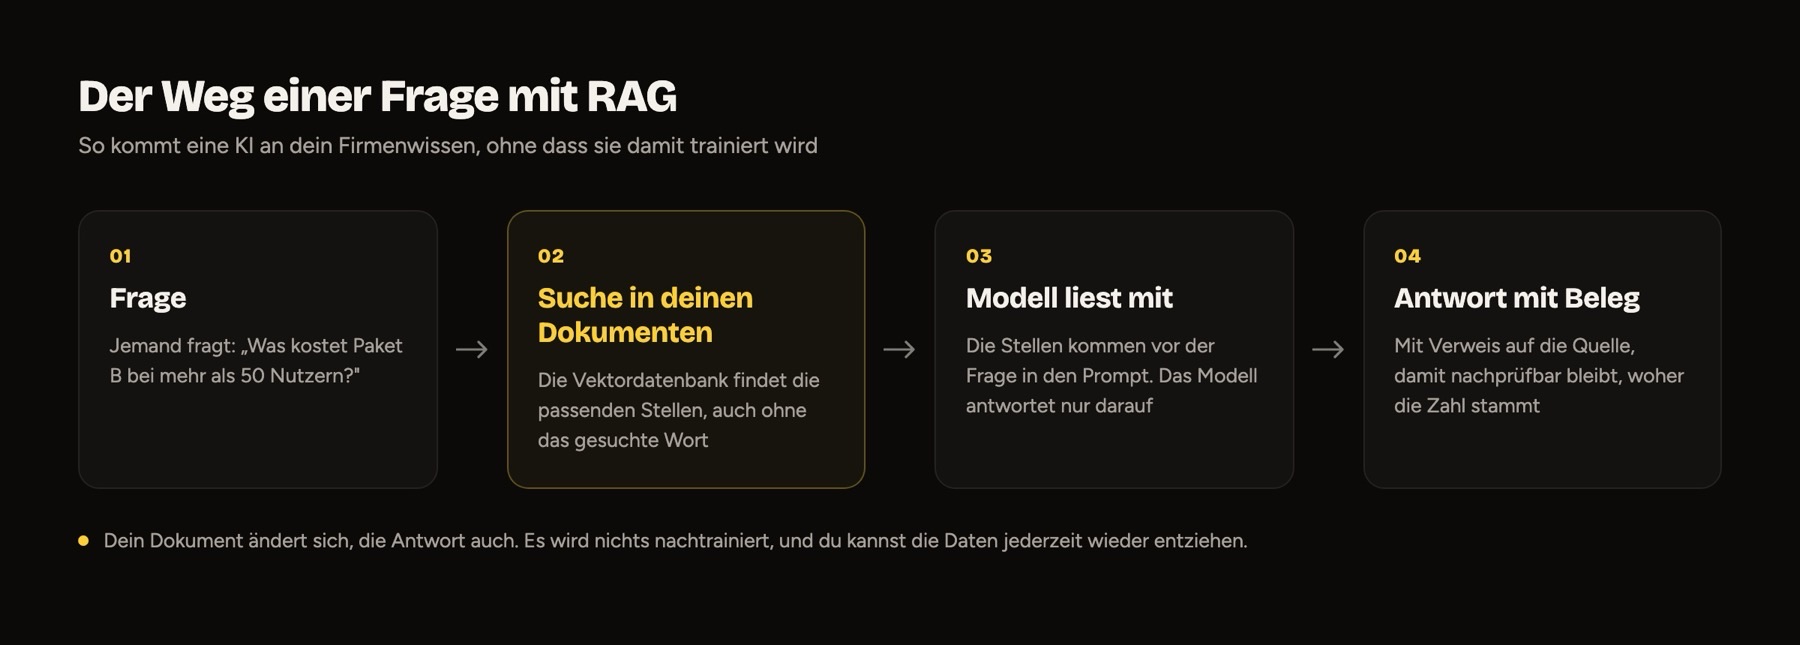
Der Weg einer Frage mit RAG, in vier Schritten:
- Frage. Jemand fragt: "Was kostet Paket B bei mehr als 50 Nutzern?"
- Suche in deinen Dokumenten. Die Vektordatenbank findet die passenden Stellen, auch ohne das gesuchte Wort.
- Modell liest mit. Die Stellen kommen vor der Frage in den Prompt. Das Modell antwortet nur darauf.
- Antwort mit Beleg. Mit Verweis auf die Quelle, damit nachprüfbar bleibt, woher die Zahl stammt.
Ändert sich dein Dokument, ändert sich die Antwort. Nachtrainiert wird nichts, und du kannst die Daten jederzeit wieder entziehen.
RAG (Retrieval Augmented Generation) ist das Verfahren, bei dem passende Ausschnitte aus deinen Dokumenten vor der Antwort in den Prompt gelegt werden. Das Modell antwortet auf dieser Grundlage. Für Firmenwissen ist das in den meisten Fällen der richtige Weg.
Ein Embedding ist die Übersetzung eines Textes in eine Zahlenreihe, die seine Bedeutung abbildet. Ähnliche Texte bekommen ähnliche Zahlenreihen. So findet RAG die richtige Stelle, auch wenn das gesuchte Wort dort gar nicht vorkommt.
Eine Vektordatenbank ist der Speicher für Embeddings, der ähnliche Einträge schnell findet. Sie ist das Gedächtnis hinter RAG.
Feintuning ist das Nachtrainieren eines Modells mit eigenen Daten. Es ist teuer und fast nie die richtige erste Wahl. Für Fachwissen nimm RAG, Feintuning lohnt sich eher für Tonfall und feste Formate.
Das Model Context Protocol (MCP) ist ein offener Standard dafür, wie ein Sprachmodell an externe Werkzeuge und Datenquellen kommt. Statt für jedes Modell eine eigene Anbindung zu bauen, sprechen alle dieselbe Sprache.
Was ist der Unterschied zwischen einem Chatbot und einem KI-Agenten?
Ein Chatbot antwortet. Ein Agent handelt. Das ist der ganze Unterschied, und er entscheidet darüber, was schiefgehen kann.
Ein KI-Agent ist ein Sprachmodell, das Werkzeuge benutzen darf: eine Datenbank abfragen, eine Mail schreiben, eine Datei ändern. Entscheidend ist nicht, dass er Werkzeuge hat, sondern welche. Ein Agent, der nur lesen darf, kann nichts kaputt machen, aber eben auch nichts bewirken. Diese Frage gehört in jedes Angebot: Welche Werkzeuge bekommt der Agent, und welche davon wirken nach außen?
Agentic AI bezeichnet mehrere Agenten, die gemeinsam eine größere Aufgabe über mehrere Schritte bearbeiten. Der Begriff wird derzeit für sehr Unterschiedliches benutzt, von einer einfachen Wiederholungsschleife bis zu einem ganzen Team mit Planung. Lass dir zeigen, was im konkreten Fall gemeint ist.
Tool Calling oder Werkzeugaufruf ist die Fähigkeit eines Modells, vorgegebene Funktionen aufzurufen. Die Liste dieser Funktionen ist die eigentliche Sicherheitsgrenze.
Orchestrierung ist die Steuerung, welcher Agent wann was tut. Ab drei Agenten ist das der Teil, an dem Projekte scheitern, nicht die Modellqualität.
Human in the Loop heißt, dass ein Mensch bestätigt, bevor etwas nach außen wirkt: senden, bezahlen, veröffentlichen, löschen. Das ist kein Misstrauen gegenüber der Technik, sondern die billigste Versicherung, die du bekommen kannst.
Guardrails oder Leitplanken sind technische Grenzen, die ein Agent nicht überschreiten kann. Gut gebaut stehen sie im Code und nicht im Prompt. Ein Prompt ist eine Bitte, keine Sperre.
Prompt Injection ist ein Angriff, bei dem Anweisungen in Daten versteckt werden, die das Modell liest: in einer Webseite, einer Mail, einem Dokument. Verarbeitet dein Agent fremde Inhalte, ist das die wichtigste Frage an deinen Dienstleister.
Welche Begriffe brauche ich bei Automatisierung?
Ein Workflow ist eine festgelegte Abfolge von Schritten, die ohne dich abläuft. Der Unterschied zur KI ist Wiederholbarkeit: Ein Workflow macht jedes Mal exakt dasselbe.
Ein Trigger ist das Ereignis, das einen Workflow startet, zum Beispiel eine eingehende Mail, ein abgeschicktes Formular oder eine Uhrzeit.
Ein Webhook ist ein Ruf von System zu System in dem Moment, in dem etwas passiert. Die Alternative ist regelmäßiges Nachfragen, was langsamer und teurer ist.
Eine API ist der definierte Weg, auf dem zwei Programme miteinander reden. Hat ein Werkzeug keine API, wird jede Automatisierung daran teuer.
iPaaS sind Plattformen, auf denen Workflows zusammengeklickt werden, etwa n8n, Make oder Zapier. Sie sind gut für Standardfälle und schnell am Ende, sobald die Logik eigen wird.
RPA (Robotic Process Automation) ist Software, die eine Oberfläche bedient wie ein Mensch, inklusive Mausklicks. Der letzte Ausweg, wenn es keine Schnittstelle gibt, und entsprechend anfällig für jede Designänderung.
Idempotenz heißt, dass derselbe Vorgang zweimal ausgeführt dasselbe Ergebnis hat wie einmal. Das klingt theoretisch und ist der Unterschied zwischen einer Rechnung und zwei Rechnungen, wenn ein Lauf wiederholt wird.
Latenz ist die Wartezeit für eine einzelne Antwort, Durchsatz die Menge an Vorgängen pro Stunde. Für einen Chat zählt Latenz, für eine nächtliche Verarbeitung Durchsatz. Wer beides gleichzeitig optimieren will, zahlt doppelt.
Was bedeutet GEO und wie unterscheidet es sich von SEO?
SEO sorgt dafür, dass deine Seite in klassischen Suchergebnissen gefunden wird. GEO (Generative Engine Optimization) verfolgt dasselbe Ziel in KI-Antworten, also in ChatGPT, Perplexity und den KI-Übersichten von Google. Der Unterschied liegt in dem, was belohnt wird. Die Arbeit "GEO: Generative Engine Optimization" von Forschenden aus Princeton, Georgia Tech und IIT Delhi, vorgestellt auf der KDD 2024, hat dafür 10.000 Suchanfragen aus acht Themenfeldern untersucht. Ergebnis: Konkrete Statistiken im Text erhöhen die Sichtbarkeit in KI-Antworten um bis zu 40 Prozent, das Zitieren belastbarer Quellen um bis zu 47 Prozent. Über alle geprüften Strategien lag der Zuwachs zwischen 22 und 41 Prozent. Keyword-Stuffing hat die Sichtbarkeit dagegen aktiv verschlechtert. Für dich heißt das: Dieselbe Seite, anders geschrieben, kann in KI-Antworten auftauchen oder eben nicht.
AI Overviews sind die von Google erzeugten Antwortkästen über den Suchergebnissen. Sie beantworten viele Fragen direkt, wodurch Sichtbarkeit und Klickzahlen auseinanderlaufen. Wer nur Klicks misst, hält das für einen Rückgang.
llms.txt ist eine Datei, mit der eine Website KI-Systemen Hinweise geben möchte. Sie ist ein Vorschlag und kein Standard, Google wertet sie nicht aus. Sie zu haben schadet nicht, sie ersetzt aber keine saubere Struktur.
Was muss ich rechtlich wissen?
Der EU AI Act ist die europäische KI-Verordnung. Sie teilt Anwendungen in Risikoklassen ein, von verboten über hochriskant bis minimal. Für die meisten mittelständischen Anwendungen ist Artikel 50 der entscheidende Teil: Menschen müssen erkennen können, dass sie mit einer KI sprechen, und KI-erzeugte Inhalte müssen gekennzeichnet sein. Diese Transparenzpflichten gelten seit dem 2. August 2026. Die Pflichten für hochriskante Systeme nach Artikel 6 Absatz 2 und Anhang III greifen am 2. Dezember 2027. Für generative Systeme, die vor August 2026 bereits auf dem Markt waren, läuft für die maschinenlesbare Kennzeichnung eine Frist bis zum 2. Dezember 2026. Wenn auf deiner Website ein Chatbot läuft, betrifft dich das heute und nicht irgendwann.
Auftragsverarbeitung (AVV) ist der Vertrag, den du mit einem Anbieter brauchst, sobald personenbezogene Daten an ihn gehen. Dazu kommt eine Rechtsgrundlage nach DSGVO. Das ist die Frage, die in Projekten am häufigsten zu spät gestellt wird.
Datenresidenz bezeichnet den Ort, an dem Daten physisch verarbeitet werden. Manche Anbieter garantieren die EU, manche nicht, manche nur in bestimmten Tarifen.
Zero Data Retention heißt, dass der Anbieter deine Anfragen nicht speichert und nicht damit trainiert. Lass dir das schriftlich geben. Es ist oft eine Einstellung und keine Eigenschaft des Produkts.
Die fünf Begriffe, die am häufigsten falsch benutzt werden
Diese fünf Verwechslungen kosten in Projekten regelmäßig Geld, weil beide Seiten dasselbe Wort für Verschiedenes benutzen.
- "Die KI lernt aus unseren Daten." In den meisten Projekten stimmt das nicht. Das Modell liest deine Daten bei jeder Anfrage neu und lernt sie nicht. Das ist eine gute Nachricht, denn so kannst du sie auch wieder entziehen.
- "Agent" für einen Chatbot. Ein Chatbot antwortet, ein Agent handelt. Passiert nichts außer Text, ist es kein Agent.
- "Halluzinationsfrei." Gibt es nicht. Es gibt nur Aufbauten, in denen das Modell wenig zu erfinden hat.
- "Automatisierung" für eine Textvorlage. Ein gespeicherter Baustein spart Tipparbeit. Eine Automatisierung läuft ohne dich.
- "Echtzeit." Fast nie gemeint. Meist heißt es "innerhalb weniger Minuten", und das genügt auch.
Vier Fragen, mit denen du jedes KI-Angebot prüfst
- Welche Daten sieht das Modell, und bleibt es bei RAG oder wird trainiert?
- Welche Werkzeuge darf der Agent benutzen, und welche davon wirken nach außen?
- An welcher Stelle bestätigt ein Mensch, bevor etwas rausgeht?
- Was kostet ein typischer Vorgang in Token, getrennt nach Eingabe und Ausgabe?
Wer darauf klar antwortet, hat sein System verstanden. Wer ausweicht, baut es gerade erst.
Mehr zu einzelnen Themen findest du in unseren Beiträgen zu ChatGPT und Künstlicher Intelligenz, den besten KI-Tools für dein Marketing und zu Web Analytics.
Wenn du wissen willst, welcher dieser Begriffe für dein Unternehmen überhaupt eine Rolle spielt, nimm dir fünfzehn Minuten. Wir sagen dir auch, wenn die ehrliche Antwort "keiner davon" lautet: Kostenloses Erstgespräch buchen.
Quellen
- Europäische Kommission, Transparenzpflichten nach Artikel 50 des AI Act: digital-strategy.ec.europa.eu
- Artikel 50 der KI-Verordnung im Volltext: artificialintelligenceact.eu
- Aggarwal u. a., "GEO: Generative Engine Optimization", KDD 2024 (Princeton, Georgia Tech, IIT Delhi): arxiv.org/abs/2311.09735
- Europäische Kommission, Leitlinien zu den Transparenzpflichten: digital-strategy.ec.europa.eu
Gründer von the zign, KI-Agentur für Websites, Marketing und Automatisierung. Seit 2022 helfen wir KMUs dabei, mehr mit weniger Aufwand zu erreichen.